CORE AX TECHNOLOGY
AIナレッジ構築
分散した企業情報を、AIが使える知識へ。
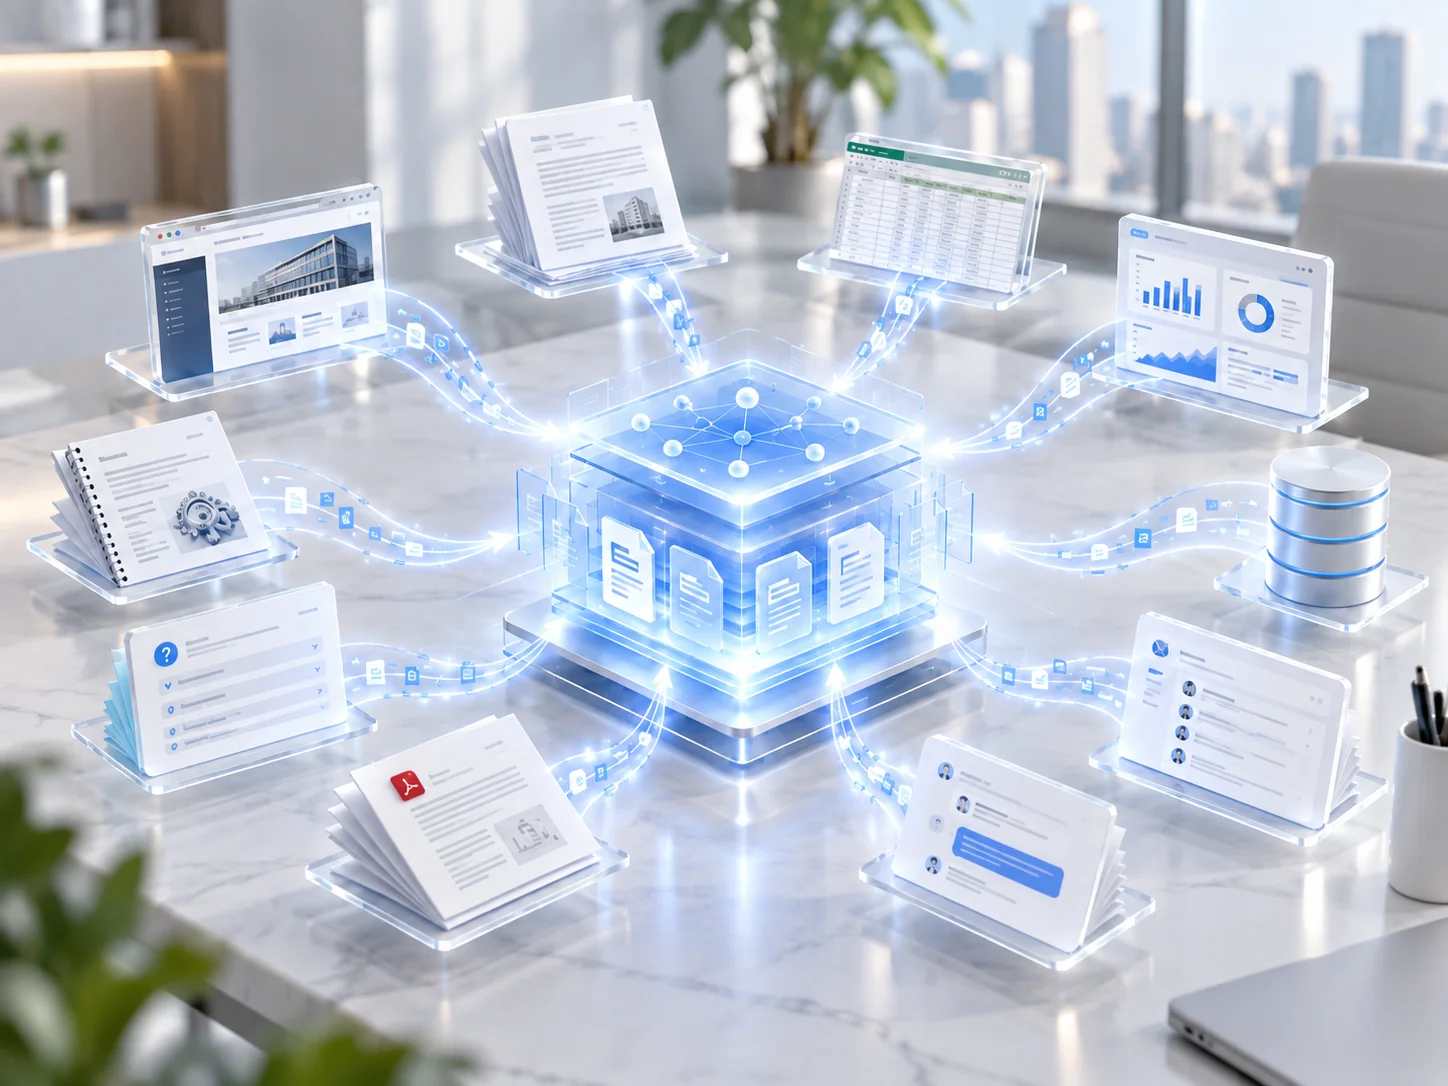
Webサイト、文書、FAQ、マニュアル、業務データなど、企業がすでに持つ情報を収集・構造化し、AIが必要な根拠を正確に見つけて活用できるKnowledgeを構築します。
WHY AI KNOWLEDGE
情報があるからといって、AIが使えるとは限りません。
既存の企業情報
情報はあっても、互いに分散しています。
ページや文書ごとに形式が異なり、同じ情報が複数の場所に分散し、出典や関係が切り離されています。
- Webサイト
- 文書
- FAQ
- マニュアル
- メール
- 業務システム
- DB/API
- ···
AI Knowledge
AIが見つけて使える、一つのKnowledgeへ。
分散した情報を意味単位で構造化し、出典、文脈、関係、権限まで紐付けて、AIが活用できる知識を構築します。
- 意味
- 文脈
- 出典
- 関係
- 権限
情報を集めるだけではありません。AIが使える構造へと変換します。
KNOWLEDGE PIPELINE
元の情報から、検索可能なKnowledgeへ。
入力
構造化
文書やページをそのまま保存するのではなく、情報が属するページ、セクション、テーマ、業務上の文脈に沿って構造を付与します。
文書 · ページ · セクション · テーマ · 業務上の文脈
検索
03
構造化
文書やページをそのまま保存するのではなく、情報が属するページ、セクション、テーマ、業務上の文脈に沿って構造を付与します。
文書 · ページ · セクション · テーマ · 業務上の文脈
原文を保存するだけではありません。検索可能な意味の構造へと変換します。
KNOWLEDGE STRUCTURE
内容を保存するだけではありません。その情報の文脈まで紐付けます。
CONTENT
- ページ
- 文書
- FAQ
- マニュアル
KNOWLEDGE
AI-READYKNOWLEDGE
CONTEXT
- 出典
- カテゴリ
- 作成者 / 日付
- アクセス権限
- 元データの場所
Knowledge検索
質問の意味と条件に合うKnowledgeを見つけます。
表現が異なっても意味を理解し、必要な条件を併せて適用することで、最適な根拠を見つけます。
セマンティック検索
表現が異なっていても、意味の近い情報を見つけます。
メタデータフィルタ
カテゴリ、文書の種類、権限、日付などの条件を併せて適用します。
ハイブリッド検索
必要に応じて、意味検索とキーワード検索を組み合わせます。
KNOWLEDGE LIFECYCLE
企業の情報が変われば、Knowledgeも変わる必要があります。
更新
元のページ・文書・データの変更を検知
同期
変更された情報のみをKnowledgeに反映
バージョン管理
情報の変更時点とバージョンを管理
検証
検索結果と回答の根拠を継続的に検証
優れたAIは、優れたKnowledgeから始まります。